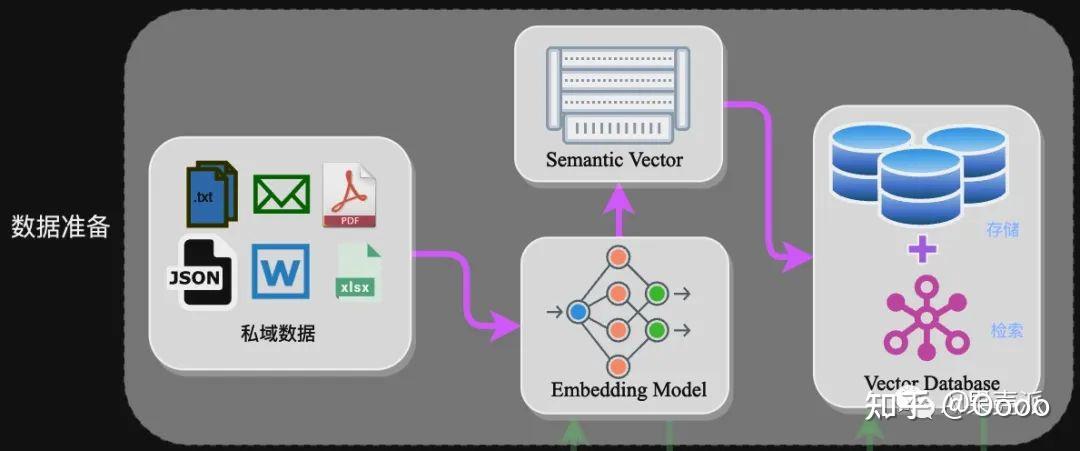
可以把传统的大模型想象成一个闭卷考生—— 他靠记忆答题,知识固定在训练时。 而 RAG 则让他带上一本参考书: 在回答前,先去知识库中检索信息,再基于这些内容生成答案
| 对比维度 | 传统大模型 | 启用 RAG |
|---|---|---|
| 知识来源 | 训练语料(静态) | 外部知识库(动态) |
| 更新方式 | 重新训练 | 更新文档即可 |
| 回答逻辑 | 依靠记忆猜测 | 依托检索事实 |
| 是否可追溯 | 否 | 是,可附来源 |
RAG 的过程 : 把问题转成语义向量;
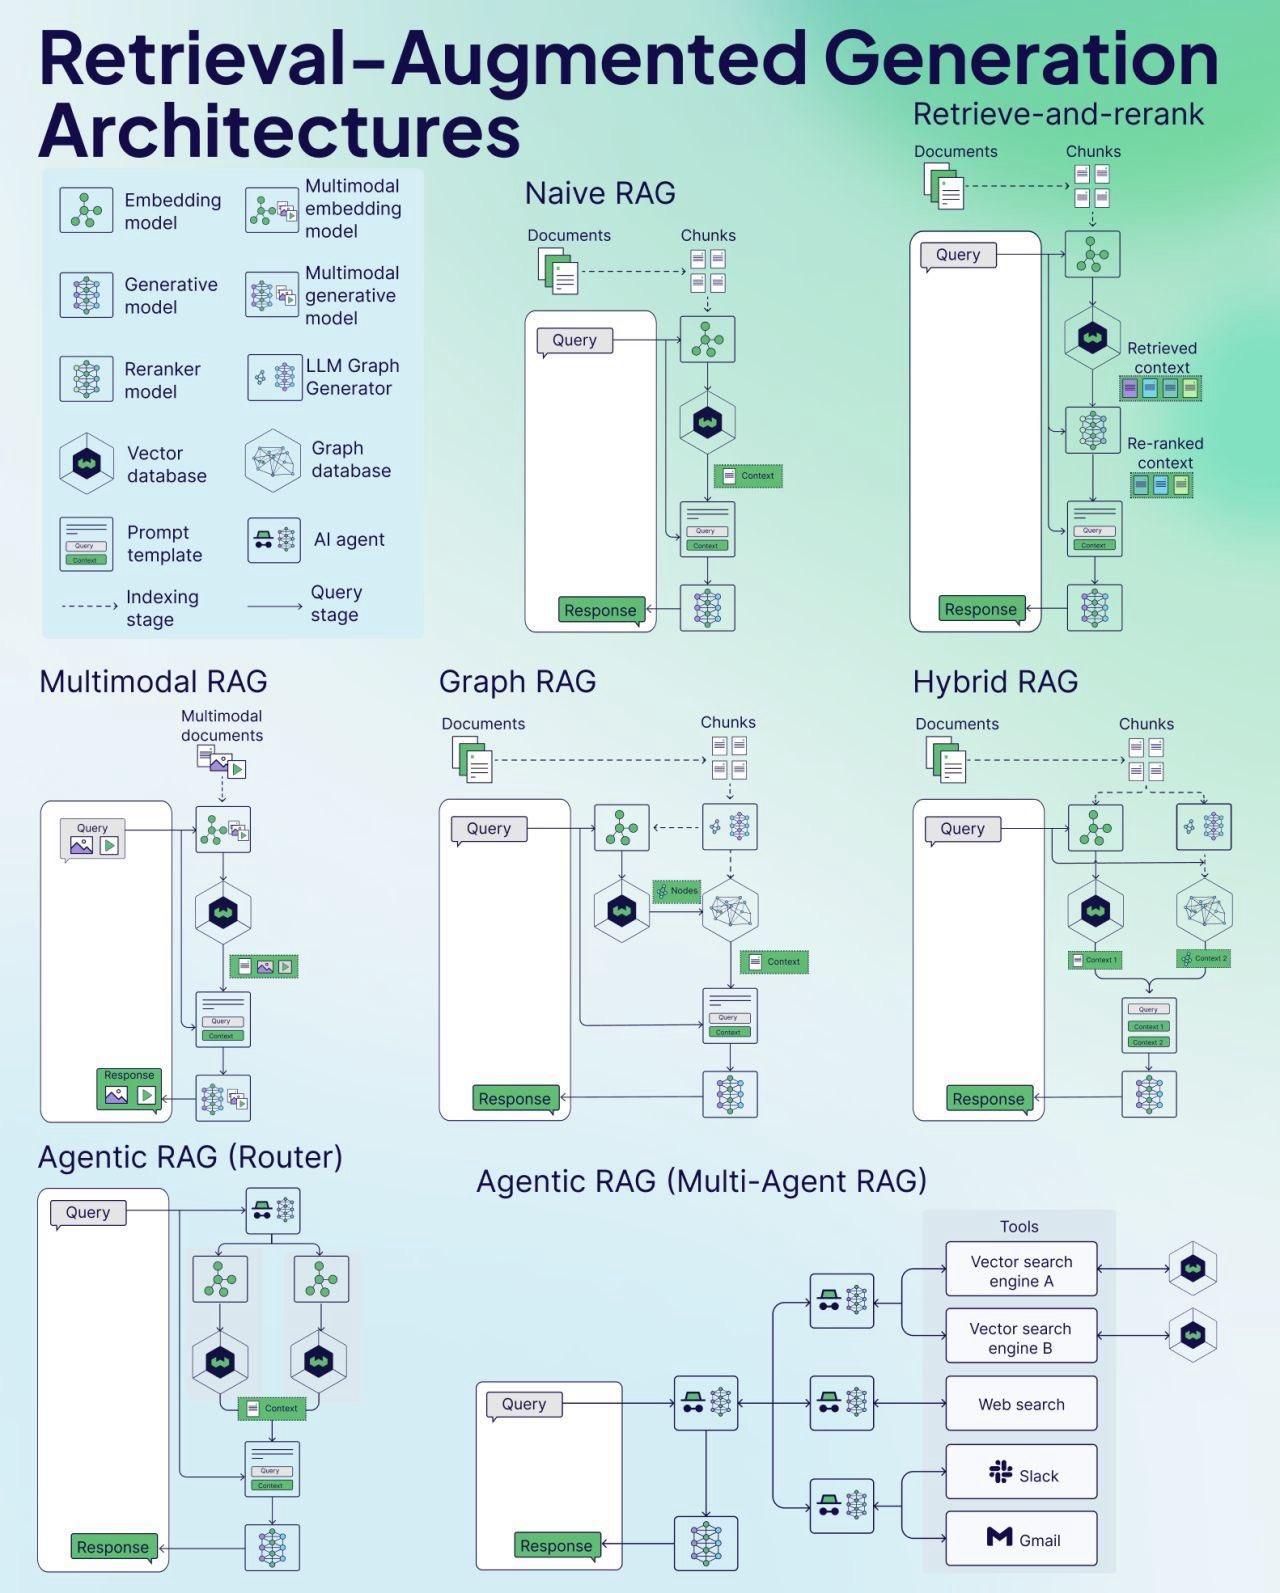
这就是网上传播很广泛的 7 个RAG架构(会在后面分七次文章讲解)
完整的RAG应用流程主要包含两个阶段:
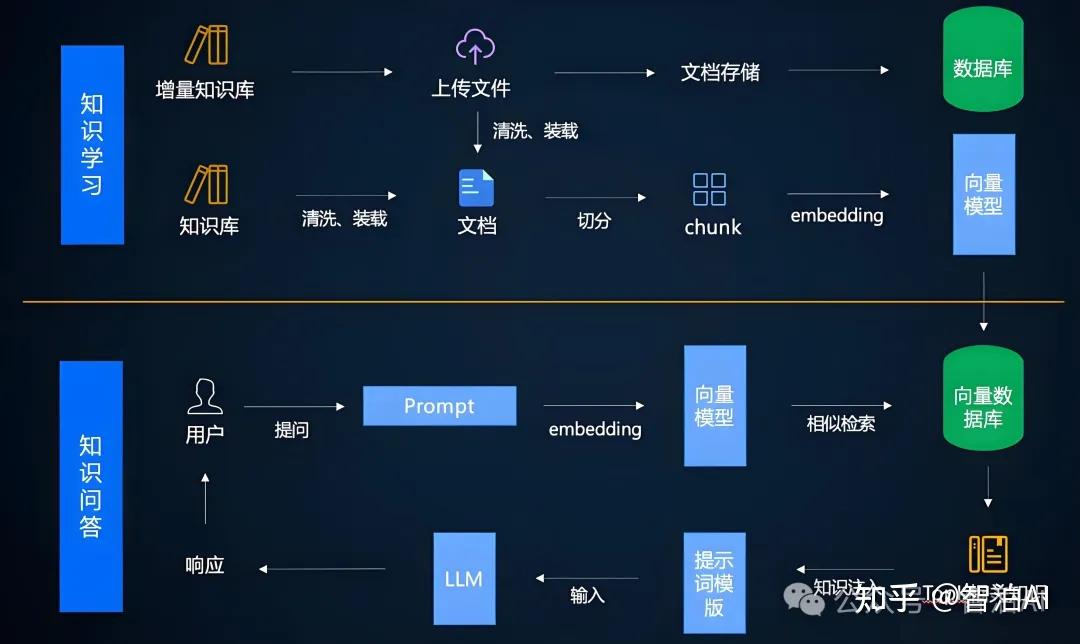
数据准备一般是一个离线的过程,主要是将私域数据向量化后构建索引并存入数据库的过程。主要包括:数据提取、文本分割、向量化、数据入库等环节。